Sprachen
 EN
Klassische Software arbeitet nach fest programmierten Regeln. Weicht das Ergebnis einer Funktion vom erwarteten Verhalten ab, lässt sich der Fehler häufig im Programmcode lokalisieren und gezielt beheben. Doch wie funktioniert Qualitätssicherung, wenn ein System sein Verhalten nicht ausschließlich durch vorgegebene Regeln bestimmt, sondern aus Trainingsdaten erlernt?
Hier stellt künstliche Intelligenz (KI) die Softwarequalitätssicherung vor neue Herausforderungen. Ein KI-basiertes Bilderkennungssystem kann beispielsweise Tausende Objekte korrekt identifizieren und dennoch einzelne Bilder falsch klassifizieren. Eine solche Fehlentscheidung lässt sich häufig nicht auf eine bestimmte Codezeile zurückführen und gezielt beheben.
Für das Testen bedeutet das einen grundlegenden Perspektivwechsel: Statt ausschließlich einzelne Fehler aufzudecken, muss die Qualität eines KI-Systems über eine Vielzahl von Testfällen statistisch bewertet werden. Dabei kommt es nicht nur auf die Anzahl der Tests an, sondern auch darauf, wie gut die verwendeten Testdaten die spätere Einsatzumgebung widerspiegeln.
Doch wie lässt sich unter diesen Voraussetzungen zuverlässig feststellen, ob ein KI-System die geforderte Qualität erreicht?
KI-Systeme, die auf maschinellem Lernen basieren, unterscheiden sich grundlegend von klassisch programmierten Systemen. Sie lernen aus einer Vielzahl von Trainingsbeispielen, indem die Parameter eines Modells während des Trainings angepasst werden. Ein Bilderkennungssystem lernt beispielsweise anhand zahlreicher Aufnahmen, Hunde und Katzen zu unterscheiden. Die zugrunde liegenden Merkmale werden dabei nicht vollständig durch feste Regeln vorgegeben, sondern aus den Trainingsdaten abgeleitet.
Das hat unmittelbare Konsequenzen für die Qualitätssicherung: Auch ein leistungsfähigeres KI-Modell wird nicht zwangsläufig jede Eingabe korrekt verarbeiten. Entscheidend ist daher, wie häufig Fehler auftreten und unter welchen Bedingungen sie entstehen.
Die Qualität eines KI-Systems muss deshalb zusätzlich statistisch bewertet werden. An die Stelle der ausschließlichen Betrachtung einzelner Testergebnisse tritt die Frage, wie zuverlässig das System über eine Vielzahl unterschiedlicher Eingaben hinweg arbeitet.
Wie stark die Auswahl der Testdaten das Ergebnis beeinflusst, zeigt ein einfaches Beispiel: Ein KI-basiertes Bilderkennungssystem unterscheidet zwischen Hunden und Katzen. Katzen erkennt es mit einer Genauigkeit von 95 Prozent, Hunde hingegen nur mit 85 Prozent.
Zwei Tester sollen die Qualität des Systems unabhängig voneinander überprüfen. Beide verwenden jeweils 1.000 Bilder, wählen jedoch unterschiedliche Testdatensätze. Während der erste Tester überwiegend Katzenbilder verwendet, setzt der zweite vor allem Hundebilder ein.
Die Ergebnisse unterscheiden sich deutlich:
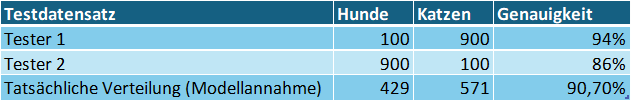
Obwohl beide Tester dasselbe System mit der gleichen Anzahl an Bildern überprüfen, erhalten sie unterschiedliche Ergebnisse. Keiner der beiden Testdatensätze bildet jedoch die im Beispiel angenommene tatsächliche Verteilung von Hunden und Katzen ab. Unter Berücksichtigung dieser Verteilung ergibt sich eine Genauigkeit von rund 90,7 Prozent.
Das Beispiel verdeutlicht ein grundlegendes Problem beim Testen von KI: Eine große Anzahl an Testfällen allein garantiert noch keine aussagekräftigen Ergebnisse. Entscheidend ist auch, ob die Testdaten die Bedingungen des späteren Einsatzbereichs realistisch widerspiegeln.
Andernfalls können selbst umfangreiche Tests ein verzerrtes Bild der tatsächlichen Leistungsfähigkeit eines KI-Systems vermitteln. Erst eine repräsentative Auswahl der Testdaten ermöglicht belastbare statistische Qualitätsaussagen.
In der klassischen Softwareentwicklung wird durch systematische Testverfahren sichergestellt, dass möglichst alle relevanten Funktionen und Eingabesituationen überprüft werden. Methoden wie Äquivalenzklassenbildung oder kombinatorisches Testen helfen dabei, umfangreiche Testszenarien mit einer zielführenden Anzahl an Tests abzudecken.
Auch beim Testen von KI-Systemen ist die Testabdeckung wichtig. Sie allein reicht jedoch nicht aus.
Für belastbare Testergebnisse müssen deshalb zwei Anforderungen erfüllt sein:
Ein Objekterkennungssystem für automatisierte Fahrzeuge sollte beispielsweise nicht nur bei Sonnenschein, Regen und Nebel getestet werden. Für eine aussagekräftige Bewertung seiner Leistungsfähigkeit muss auch die unterschiedliche Auftrittswahrscheinlichkeit dieser Wetterbedingungen im vorgesehenen Einsatzbereich berücksichtigt werden.
Das bedeutet nicht, dass seltene oder sicherheitskritische Edge Cases weniger intensiv getestet werden sollten. Solche Szenarien können gezielt zusätzliche Tests erfordern. Bei der Bewertung der Gesamtqualität muss ihre statistische Häufigkeit jedoch berücksichtigt werden.
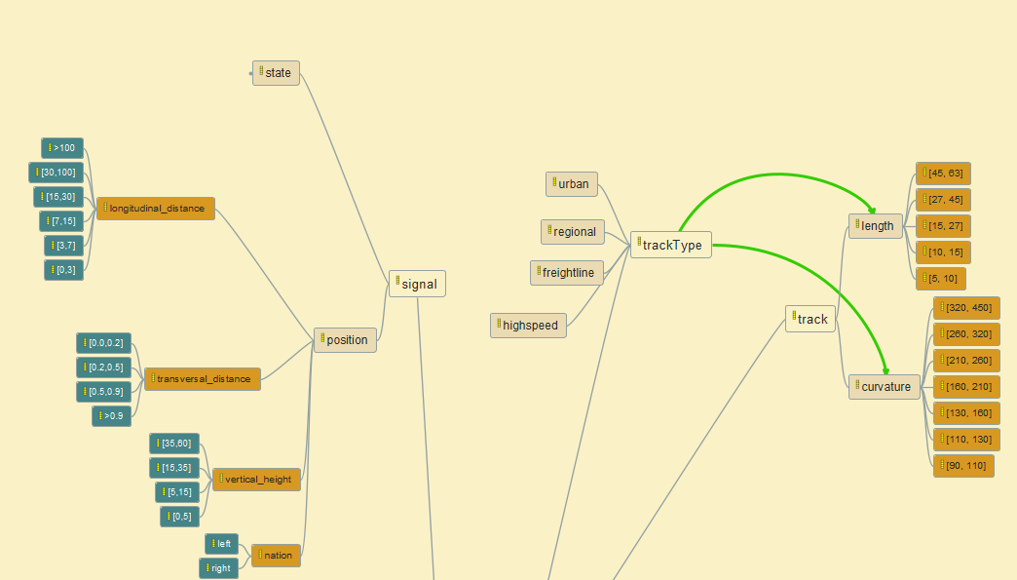
Die vorgesehene Einsatzumgebung eines Systems wird als Operational Design Domain (ODD) bezeichnet. Sie beschreibt die Rahmenbedingungen, innerhalb derer ein System seine vorgesehenen Funktionen erfüllen muss.
Bei einem automatisiert fahrenden Zug gehören dazu beispielsweise die Streckeninfrastruktur, Signale, Wetterbedingungen und mögliche Hindernisse im Gleisbereich. Diese Faktoren beeinflussen, welche Situationen das KI-System während des Betriebs erkennen und bewältigen muss.
Für eine repräsentative Teststrategie genügt es jedoch nicht, die relevanten Einflussfaktoren lediglich mit einer beliebigen Zahl an Testfellen zu adressieren. Es muss auch berücksichtigt werden, wie häufig bestimmte Situationen auftreten und welche Abhängigkeiten zwischen ihnen bestehen. Beispielsweise können Wetterbedingungen die Wahrscheinlichkeit bestimmter Sichtverhältnisse oder Hindernissituationen beeinflussen.
Eine systematische Beschreibung der Einsatzumgebung bildet damit die Grundlage für die Auswahl geeigneter Testfälle. Wird sie zusätzlich um statistische Informationen erweitert, lässt sich ein Modell entwickeln, aus dem repräsentative Tests abgeleitet werden können.
Aufgrund der statistischen Eigenschaften, stellt sich bei KI-Systemen eine entscheidende Frage: Wie viele Tests sind notwendig, um eine bestimmte Qualität zuverlässig nachzuweisen?
Angenommen, ein KI-basiertes Objekterkennungssystem soll mindestens 99 Prozent aller relevanten Objekte korrekt erkennen. Selbst wenn es in 100 Testdurchläufen keinen einzigen Fehler macht, ist damit noch nicht ausreichend belegt, dass es diese Anforderung auch im späteren Betrieb erfüllt. Das beobachtete Ergebnis unterliegt einer statistischen Unsicherheit.
Deshalb müssen beim Testen von KI neben der geforderten Qualität auch das gewünschte Konfidenzniveau und die erforderliche Anzahl an Testfällen berücksichtigt werden. Mithilfe statistischer Verfahren lässt sich abschätzen, welcher Testumfang notwendig ist, um eine Qualitätsanforderung mit einer festgelegten statistischen Sicherheit zu überprüfen.
Ein KI-Test sollte somit nicht allein dann enden, wenn alle vorgesehenen Testfälle ausgeführt wurden, sondern wenn die Ergebnisse eine hinreichend belastbare Aussage über die geforderte Qualität ermöglichen. Voraussetzung dafür bleibt, dass die Testdaten die vorgesehene Einsatzumgebung repräsentativ abbilden.
Die besonderen Eigenschaften von KI-Systemen erfordern eine entsprechend angepasste Teststrategie. Klassische Testmethoden wie Äquivalenzklassenbildung, Robustheitstests oder Simulationen bleiben dabei wichtige Bestandteile der Qualitätssicherung. Sie müssen jedoch um statistische Verfahren ergänzt werden, um belastbare Aussagen über die Leistungsfähigkeit eines KI-Systems treffen zu können.
In der Praxis bedeutet das, dass bereits bei der Testplanung die vorgesehene Einsatzumgebung systematisch beschrieben werden muss. Auf dieser Grundlage lassen sich relevante Testszenarien identifizieren und Testdaten auswählen, die sowohl eine ausreichende Abdeckung als auch eine repräsentative Verteilung gewährleisten.
Darüber hinaus müssen messbare Qualitätsziele und geeignete statistische Abschlusskriterien definiert werden. So lässt sich nicht nur feststellen, welche Fehler während des Tests aufgetreten sind, sondern auch beurteilen, ob das System die geforderte Qualität mit der angestrebten statistischen Konfidenz erreicht.
Statistische Testverfahren ersetzen klassische Methoden somit nicht, sondern ergänzen sie um eine entscheidende Dimension: die belastbare Bewertung der KI-Qualität im vorgesehenen Einsatzbereich.

Das Testen von KI-Systemen erfordert einen erweiterten Blick auf die Softwarequalität. Erst die Kombination aus systematischer Testabdeckung, repräsentativen Testdaten und statistischen Bewertungskriterien ermöglicht belastbare Aussagen darüber, wie zuverlässig ein System in seiner späteren Einsatzumgebung arbeitet.
ITPower Solutions unterstützt Unternehmen dabei, die Qualität ihrer KI-basierten Systeme systematisch und nachvollziehbar zu bewerten. Wir entwickeln geeignete Teststrategien, unterstützen bei der Auswahl repräsentativer Testdaten und erarbeiten statistisch fundierte Qualitäts- und Testende-Kriterien. So schaffen wir die Grundlage für belastbare Qualitätsaussagen, reduzieren Unsicherheiten bei der Bewertung von KI-Systemen und unterstützen unsere Kunden dabei, fundierte Entscheidungen über deren Einsatz zu treffen.

Ich bin Ihr vertrieblicher Ansprechpartner und berate Sie gerne zu allen Fragen rund um unsere Dienstleistungen und Produkte! Melden Sie sich oder vereinbaren Sie einfach einen Termin für ein kostenloses Beratungsgespräch.
Sebastian Stritz
E-Mail: sebastian.stritz@itpower.de
Telefon: +49 (0)30 6098501-17